苹果首个多模态大模型MM1曝光:论文上线,300亿参数规模、支持图像内容解读、MoE架构
文章来源:08AI导航发布时间:2025-03-18 11:07:53
以下文章来自于丨机器之心
刚刚宣布放弃造车项目的苹果公司,在当今的人工智能(AI)竞赛中落伍了。为了摆脱窘境,苹果近期放弃了造车项目,正在全面转向生成式AI领域,并且很快有了新动作,推出了一款被命名为「MM1」的多模态大模型。

从去年底开始,苹果已经加大了生成式 AI 的重视和投入。此前在 2024 苹果股东大会上,苹果 CEO 库克表示,今年将在生成式 AI 领域实现重大进展。此外,苹果宣布放弃 10 年之久的造车项目之后,一部分造车团队成员也开始转向 AI 业务。
如此种种,苹果向外界传达了加注生成式 AI 的决心。目前多模态领域的生成式 AI 技术和产品非常火爆,尤以 OpenAI 的 Sora 为代表,苹果当然也想要在该领域有所建树。
今日,在一篇由多位作者署名的论文《MM1: Methods, Analysis & Insights from Multimodal LLM Pre-training》中,苹果正式公布自家的多模态大模型研究成果 —— 这是一个具有高达 30B 参数的多模态 LLM 系列。
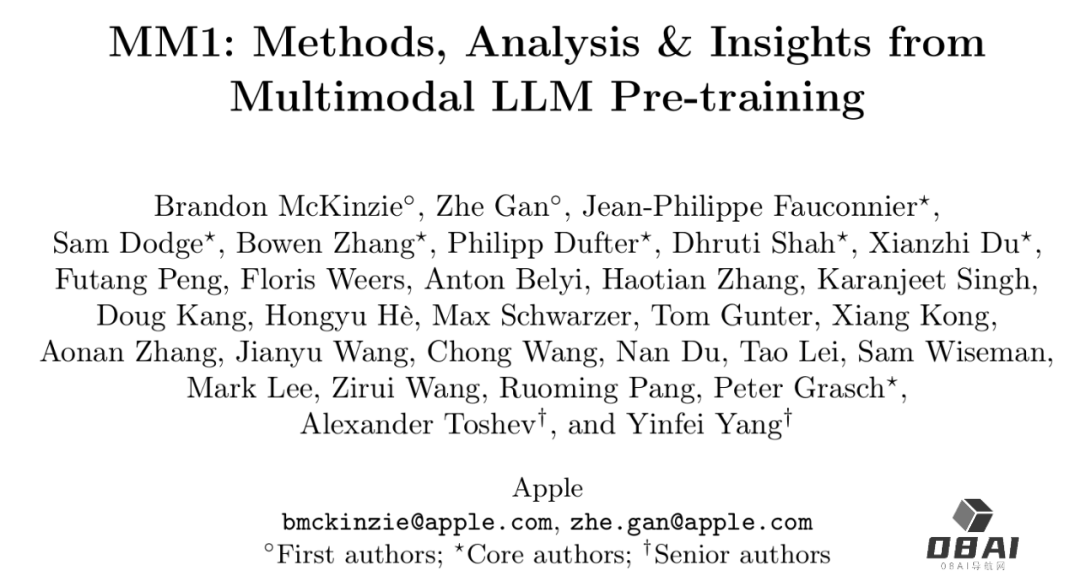
该团队在论文中探讨了不同架构组件和数据选择的重要性。并且,通过对图像编码器、视觉语言连接器和各种预训练数据的选择,他们总结出了几条关键的设计准则。具体来讲,本文的贡献主要体现在以下几个方面。
首先,研究者在模型架构决策和预训练数据选择上进行小规模消融实验,并发现了几个有趣的趋势。建模设计方面的重要性按以下顺序排列:图像分辨率、视觉编码器损失和容量以及视觉编码器预训练数据。
其次,研究者使用三种不同类型的预训练数据:图像字幕、交错图像文本和纯文本数据。他们发现,当涉及少样本和纯文本性能时,交错和纯文本训练数据非常重要,而对于零样本性能,字幕数据最重要。这些趋势在监督微调(SFT)之后仍然存在,这表明预训练期间呈现出的性能和建模决策在微调后得以保留。
最后,研究者构建了 MM1,一个参数最高可达 300 亿(其他为 30 亿、70 亿)的多模态模型系列, 它由密集模型和混合专家(MoE)变体组成,不仅在预训练指标中实现 SOTA,在一系列已有多模态基准上监督微调后也能保持有竞争力的性能。
具体来讲,预训练模型 MM1 在少样本设置下的字幕和问答任务上,要比 Emu2、Flamingo、IDEFICS 表现更好。监督微调后的 MM1 也在 12 个多模态基准上的结果也颇有竞争力。
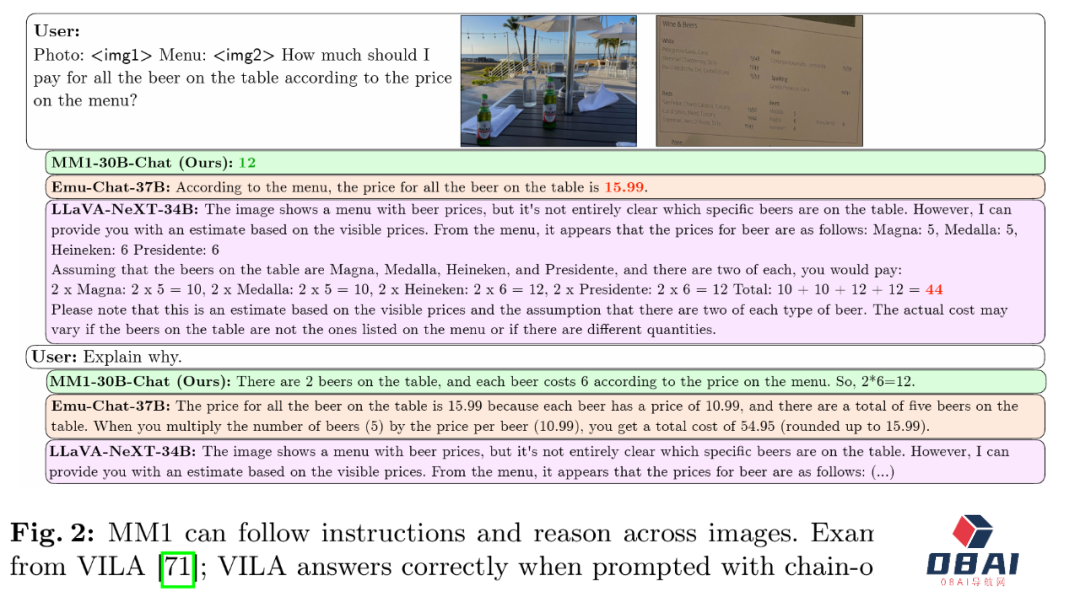
得益于大规模多模态预训练,MM1 在上下文预测、多图像和思维链推理等方面具有不错的表现。同样,MM1 在指令调优后展现出了强大的少样本学习能力。


相关攻略 更多

最新资讯 更多
-
2025年了,AI还看不懂时钟,90%人都能答对,顶尖AI全军覆没
更新时间:2025-10-14
-
光刻机龙头或领投“欧洲OpenAI”
更新时间:2025-10-14
-
华人缔造商业传奇,全球第一家突破百亿美金的AI编程企业诞生
更新时间:2025-10-14
-
具身智能进家干活,先从“AI家电”抓起?
更新时间:2025-10-14
-
前零一万物联创戴宗宏创业:20人团队,能干上百人的AI定制项目
更新时间:2025-10-14
-
阿里端出最强语音模型,英文rap精准转文字,准确率干翻全球
更新时间:2025-10-14
-
小扎「梦之队」首批论文上线,LLM自举进化,单步性能狂飙22%
更新时间:2025-10-14
-
再也不怕面瘫脸,YouTube黑科技:AI帮你「永久微笑」,连僵尸都咧嘴笑
更新时间:2025-10-14
-
2025年全球企业级AI Agent优秀厂商有哪些?
更新时间:2025-10-14
-
GPT-5 为啥不 “胡说” 了?OpenAI 新论文讲透了
更新时间:2025-10-14