微软推出Phi-3-mini迷你模型:苹果iPhone端侧就能运行,38亿参数规模就媲美GPT-3.5性能
文章来源:08AI导航发布时间:2025-03-14 17:51:53
Llama 3发布刚几天,微软就出手截胡了。
当地时间4月22日,微软推出了 Phi-3-Mini,这是一个在 3.3 万亿个代币的广泛数据集上训练的 38 亿参数规模的微型大模型。尽管体积小巧,但 Phi-3-Mini 的性能水平可与 Mixtral 8x7B 和 GPT-3.5 等等型号相媲美的大语言模型。

刚刚发布的Phi-3系列小模型技术报告,引起AI圈热议。
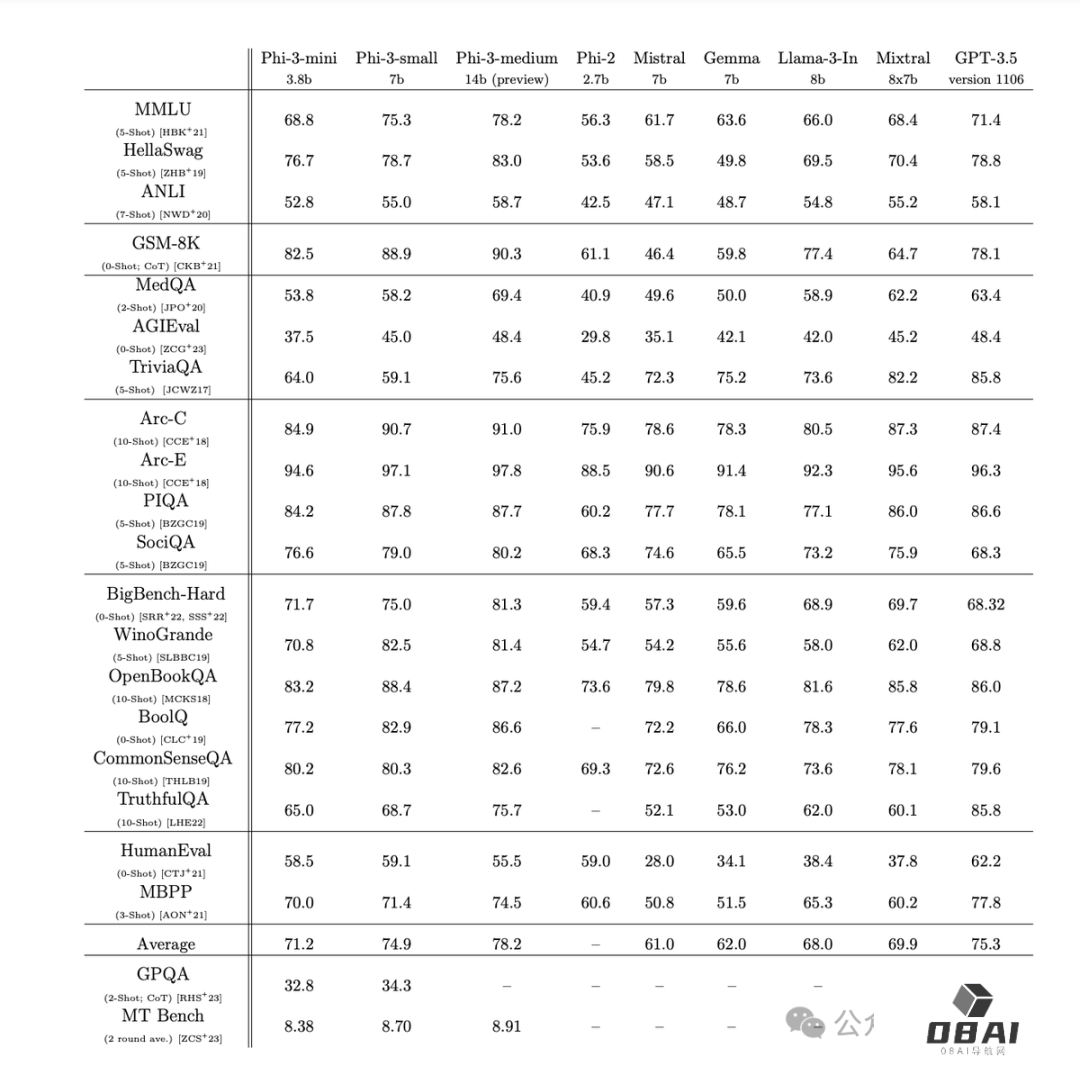
其中仅3.8B参数的Phi-3-mini在多项基准测试中超过了Llama 3 8B。
为了方便开源社区使用,还特意设计成了与Llama系列兼容的结构。
微软这次打出“手机就能直接跑的小模型”的旗号,4bit量化后的Phi-3-mini在iPhone 14 Pro和iPhone 15搭载的苹果A16芯片上跑出了每秒12 Tokens的数据。
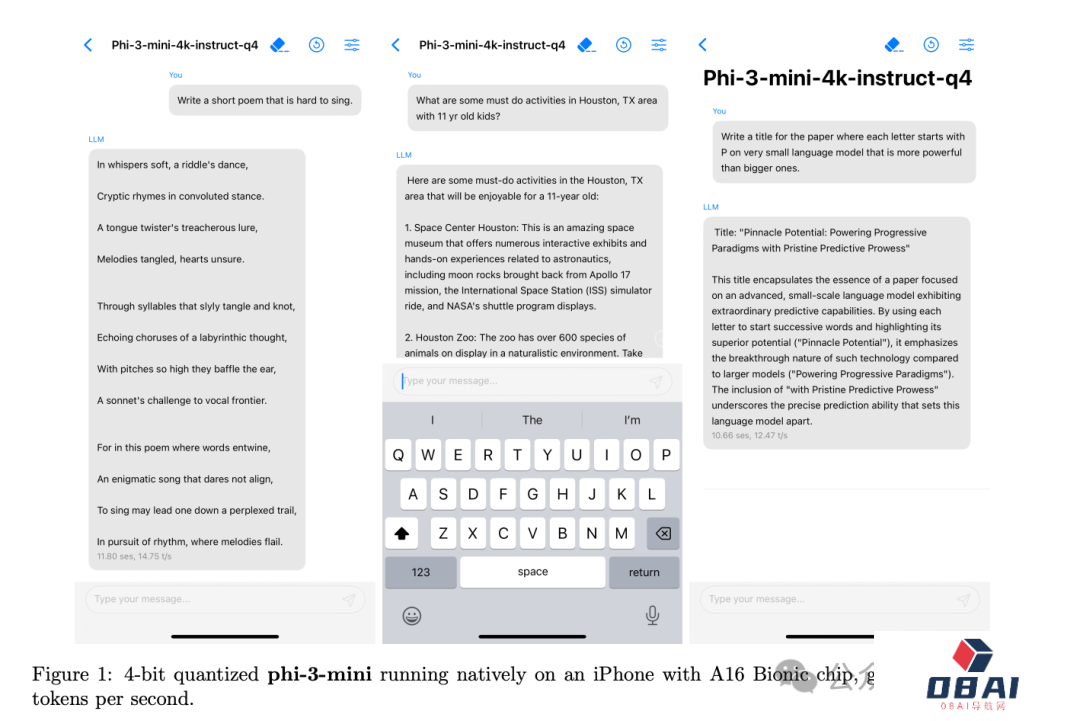
这意味着,现在手机上能本地运行的最佳开源模型,已经做到ChatGPT(GPT-3.5)的水平。
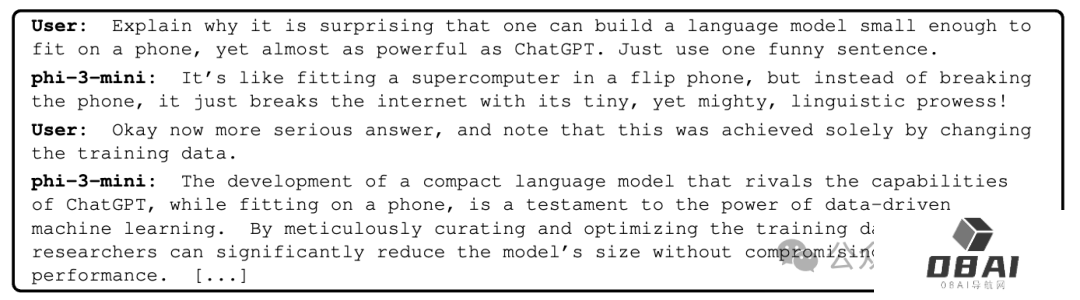
在技术报告中还玩了一把花活,让Phi-3-mini自己解释为什么构建小到手机能跑的模型很令人惊叹。
除了mini“迷你杯”之外,小杯中杯也一并发布:
Phi-3-small,7B参数,为支持多语言换用了Token分词器,并额外增加10%多语种数据。Phi-3-medium,14B参数,在更多数据上训练,多数测试中已超越GPT-3.5和Mixtral 8x7b MoE。据悉,大杯Phi-3他们目前不打算做。
作者阵容一看也不简单,一眼扫过去MSRA和MSR雷蒙德团队都投入了不少人。
那么,Phi-3系列到底有什么独特之处呢?
根据技术报告中披露,其核心秘诀就在于数据。
去年团队就发现,单纯堆砌参数量并不是提升模型性能的唯一路径。
反而是精心设计训练数据,尤其是利用大语言模型本身去生成合成数据,配合严格过滤的高质量数据,反而能让中小模型的能力大幅跃升。
也就是训练阶段只接触教科书级别的高质量数据,Textbooks are all you need。
Phi-3也延续了这一思路,这次他们更是下了血本:
投喂了多达3.3万亿Token的训练数据(medium中杯是4.8万亿)大幅强化了数据的”教育水平”过滤更多样化的合成数据,涵盖逻辑推理、知识问答等多种技能独特的指令微调和RLHF训练,大幅提升对话和安全性举个例子,比如某一天足球比赛的结果可能对于大模型是良好的训练数据,但微软团队删除了这些加强知识的数据,留下更多能提高模型推理能力的数据。
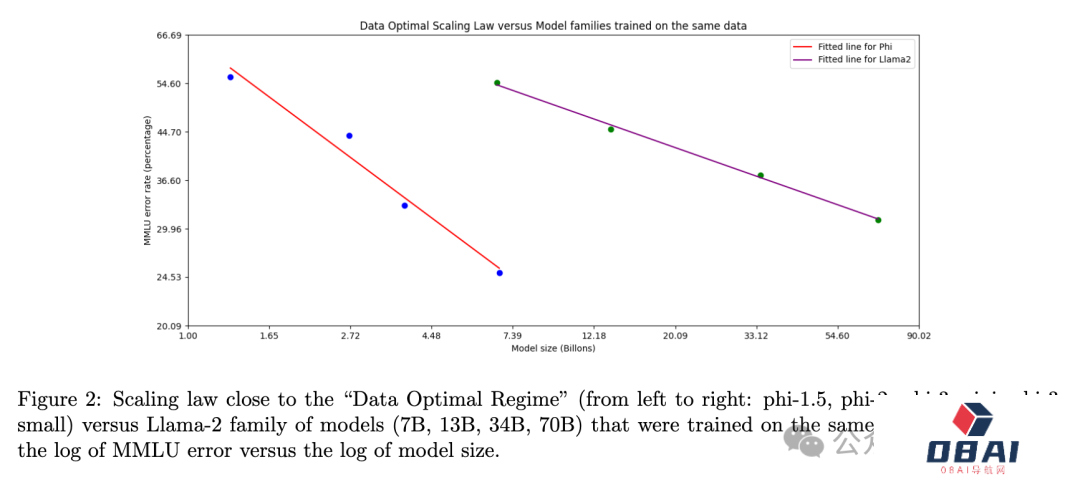
这样一来,对比Llama-2系列,就可以用更小的参数获得更高的MMLU测试分数了。
不过小模型毕竟是小模型,也不可避免存在一些弱点。
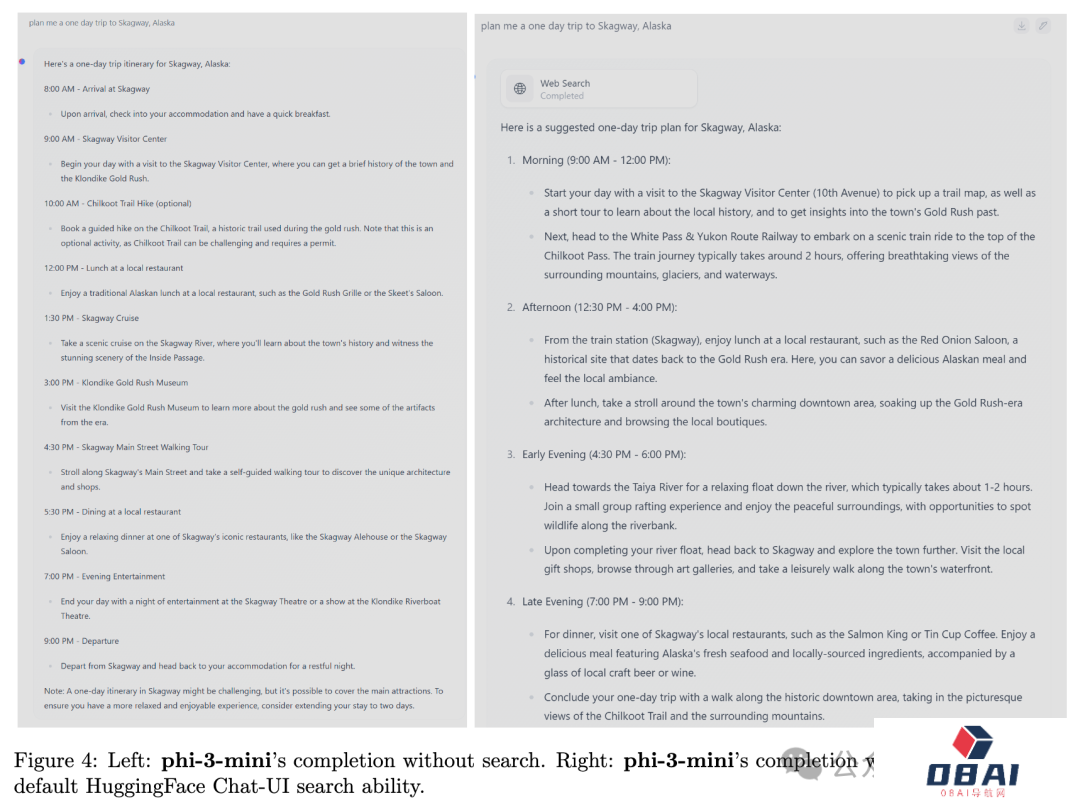
微软透露,模型本身参数中没能力存储太多事实和知识,这一点也可以从TriviaQA测试分数低看出来。
缓解办法就是联网接入搜索引擎增强。
总之,微软研究院团队是铁了心了要在小模型+数据工程这条路上走下去,未来还打算继续增强小模型的多语言能力、安全性等指标。
对于开源小模型超过ChatGPT这回事,不少网友都认为压力现在给到OpenAI这边,需要赶快推出GPT-3.5的继任者了。


相关攻略 更多

最新资讯 更多
-
2025年了,AI还看不懂时钟,90%人都能答对,顶尖AI全军覆没
更新时间:2025-10-14
-
光刻机龙头或领投“欧洲OpenAI”
更新时间:2025-10-14
-
华人缔造商业传奇,全球第一家突破百亿美金的AI编程企业诞生
更新时间:2025-10-14
-
具身智能进家干活,先从“AI家电”抓起?
更新时间:2025-10-14
-
前零一万物联创戴宗宏创业:20人团队,能干上百人的AI定制项目
更新时间:2025-10-14
-
阿里端出最强语音模型,英文rap精准转文字,准确率干翻全球
更新时间:2025-10-14
-
小扎「梦之队」首批论文上线,LLM自举进化,单步性能狂飙22%
更新时间:2025-10-14
-
再也不怕面瘫脸,YouTube黑科技:AI帮你「永久微笑」,连僵尸都咧嘴笑
更新时间:2025-10-14
-
2025年全球企业级AI Agent优秀厂商有哪些?
更新时间:2025-10-14
-
GPT-5 为啥不 “胡说” 了?OpenAI 新论文讲透了
更新时间:2025-10-14