LLM终极训练指南:在大规模GPU集群上训练大语言模型中文版
文章来源:08AI导航发布时间:2025-03-06 15:48:41
Hugging Face推出了Ultra - Scale Playbook这本指南,中文名称是LLM终极训练指南:在大规模GPU集群上训练ai大语言模型,它从基础入手,为用户在大规模GPU集群上扩展训练大语言模型(LLM)指明方向。这份指南在1到1000多个GPU集群的训练上给予全面的指导,还展示了多达512个GPU上的扩展实验成果,详细剖析了吞吐量和GPU利用率这些数据。
原文:The Ultra-Scale Playbook: Training LLMs on GPU Clusters
翻译工具:o1,o3-mini
校对者:@Ki_Seki_here
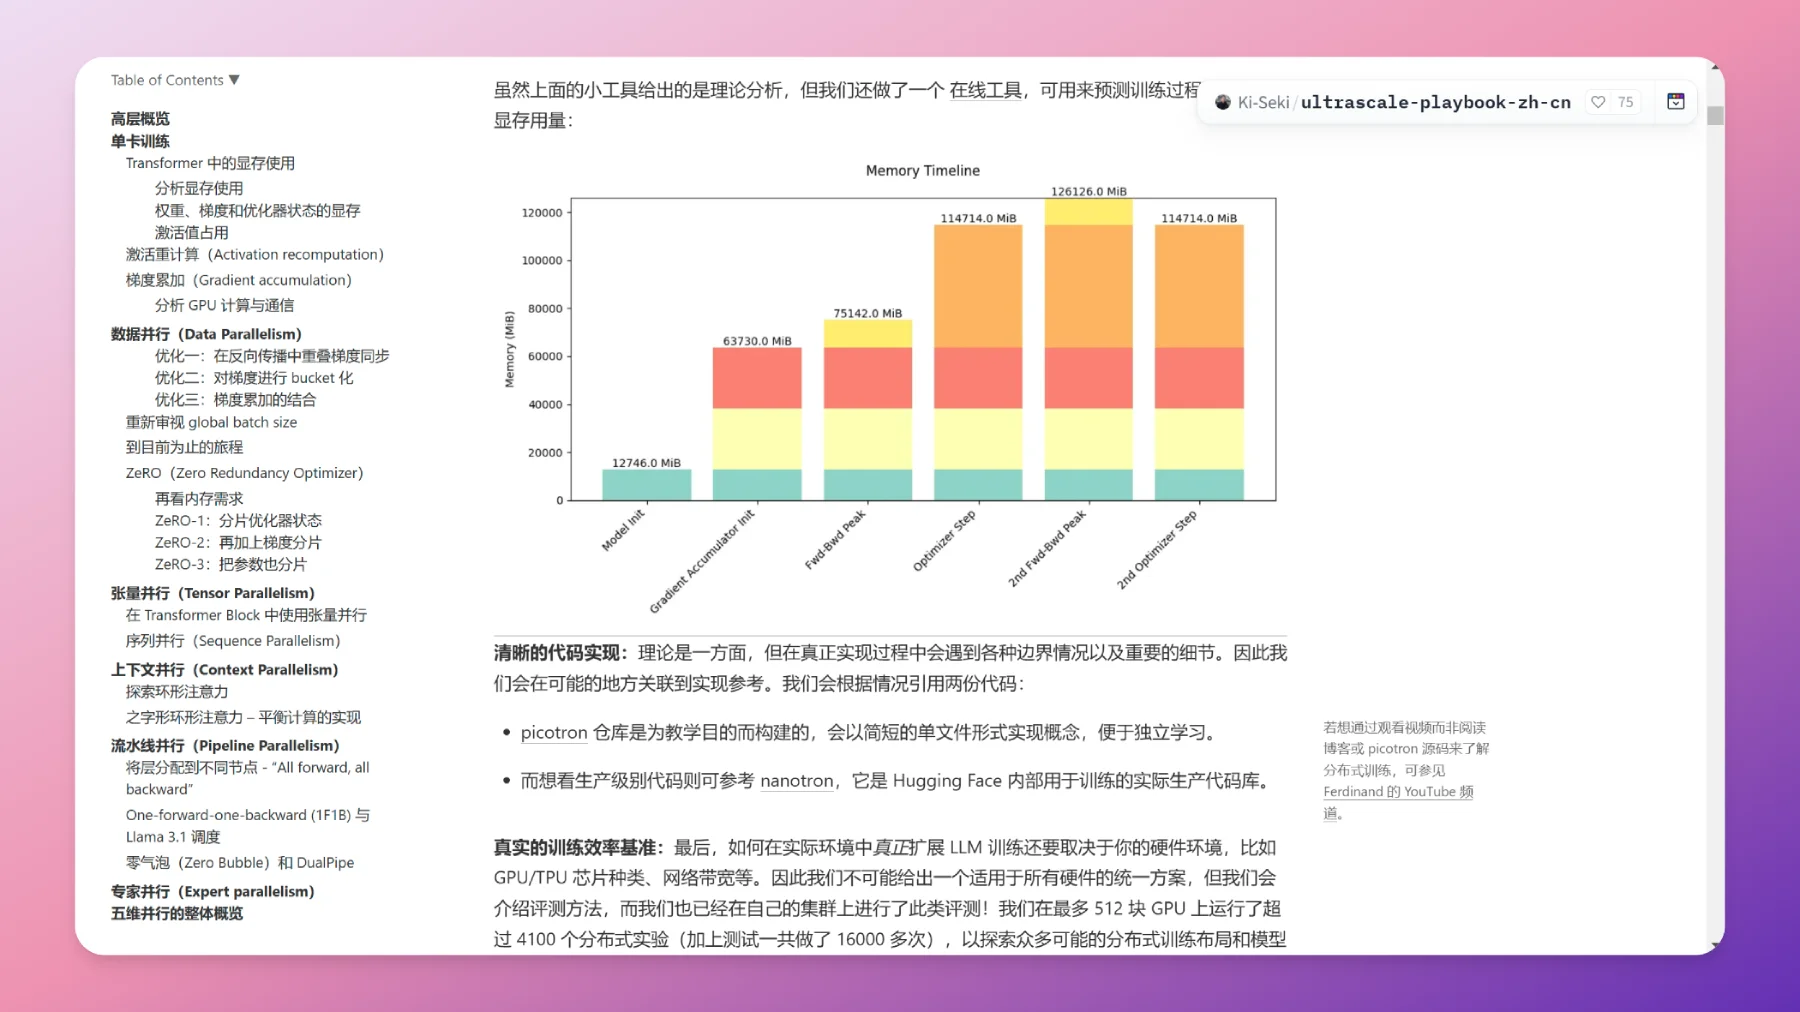
LLM终极训练指南中文版网址:https://huggingface.co/spaces/Ki-Seki/ultrascale-playbook-zh-cn
仍在校对中...

研究的来由
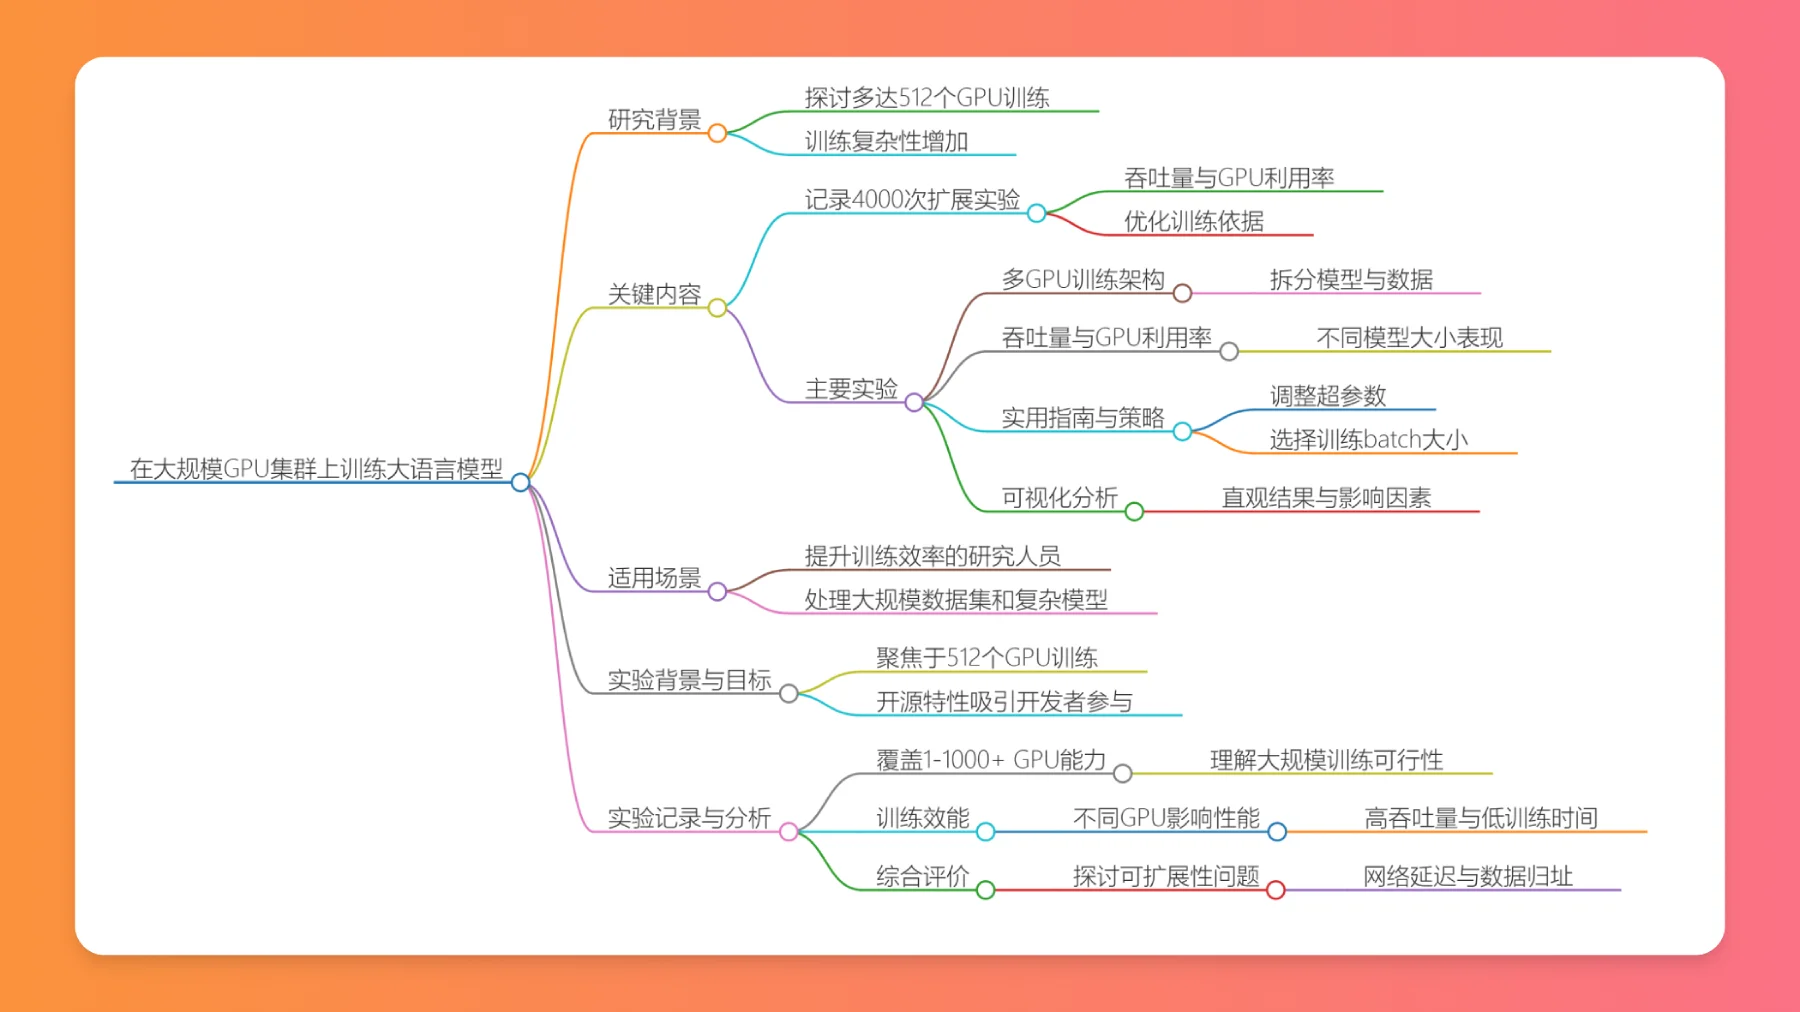
随着语言模型规模不断扩大,训练时对计算资源的需求增多,策略也越发复杂。所以,这个文档主要聚焦怎样在多达512个GPU的集群上开展大规模语言模型(LLM)训练。
重点内容
海量实验记录
文档中详细记录了4000次扩展实验。在这些实验里,吞吐量(标记大小)和GPU利用率(标记颜色)是核心衡量指标。这些数据能够为训练过程的优化提供可靠的支撑。
主要实验内容
多GPU训练架构:采用的架构能有效地拆分模型与数据,让多个GPU可以并行处理相关任务,这为高效训练提供了架构基础。
吞吐量与GPU利用率:通过实际的实验数据分析,在不同模型大小下其性能有所不同。这样的分析有助于开发者理解怎样最大程度地利用资源,从而找到适合自己的训练方式。
实用指南与策略:总结了实用的训练策略,例如如何调整超参数、选择合适的训练batch大小等,这些都是达成最佳性能的重要因素。
可视化分析:文档里包含众多可视化结果。这些结果方便用户直观地了解扩展实验的结果以及背后的影响因素,使得复杂的实验结果容易被解读。
适用对象
这个指南特别适合那些想要提升大语言模型训练效率的研究人员和工程师,特别是他们在处理大规模的数据集和复杂模型的时候。
实验的相关考量
文档特点与目标
这篇文档不单单只讲如何在512个GPU上训练,还着重强调它开源的特性。这使得更多开发者有能力参与进来并且运用这些训练方法。
实验记录范围
实验记录的范围从1个GPU一直延伸到1000多个GPU的扩展能力。这就构成了一个全面的框架,有助于人们理解在大规模集群上训练LLMs时是否可行以及效率如何。
训练效能的分析
当观察不同GPU数量给训练性能带来影响的时候,作者发现有些模型在扩展过程中能拥有更高的吞吐量并且训练时间更低。这一发现可以为开发者在选择GPU数量和配置的时候提供更具针对性的建议。
综合考量因素
除了关注性能指标之外,这个实验还深入探讨了在实际应用中的可扩展性问题。同时也研究了在真实环境下可能遭遇的一些挑战,像网络延迟、数据归址等复杂的因素,这些都是在开展大规模训练时不能忽视的部分。


相关攻略 更多

最新资讯 更多
-
2025年了,AI还看不懂时钟,90%人都能答对,顶尖AI全军覆没
更新时间:2025-10-14
-
光刻机龙头或领投“欧洲OpenAI”
更新时间:2025-10-14
-
华人缔造商业传奇,全球第一家突破百亿美金的AI编程企业诞生
更新时间:2025-10-14
-
具身智能进家干活,先从“AI家电”抓起?
更新时间:2025-10-14
-
前零一万物联创戴宗宏创业:20人团队,能干上百人的AI定制项目
更新时间:2025-10-14
-
阿里端出最强语音模型,英文rap精准转文字,准确率干翻全球
更新时间:2025-10-14
-
小扎「梦之队」首批论文上线,LLM自举进化,单步性能狂飙22%
更新时间:2025-10-14
-
再也不怕面瘫脸,YouTube黑科技:AI帮你「永久微笑」,连僵尸都咧嘴笑
更新时间:2025-10-14
-
2025年全球企业级AI Agent优秀厂商有哪些?
更新时间:2025-10-14
-
GPT-5 为啥不 “胡说” 了?OpenAI 新论文讲透了
更新时间:2025-10-14